
1. Pendahuluan
Dalam lanskap pengembangan kecerdasan buatan dan machine learning modern, pemodelan prediktif yang akurat, stabil, dan tepercaya merupakan kebutuhan fundamental. Pendekatan tradisional dalam pembelajaran mesin umumnya mengandalkan penggunaan algoritma tunggal (single estimator) seperti K-Nearest Neighbors (KNN), Decision Tree, Naive Bayes, maupun Classification and Regression Trees (CART) untuk mempelajari pola dari suatu kumpulan data (dataset). Namun, penggunaan algoritma tunggal sering kali dihadapkan pada keterbatasan performa dan risiko generalisasi yang buruk.
Setiap algoritma memiliki sifat matematis dan sudut pandang tersendiri dalam memproses fitur-fitur data. Ketika seorang praktisi data melakukan pengujian terhadap beberapa algoritma tunggal dan hanya memilih satu model dengan tingkat akurasi tertinggi, algoritma lainnya secara otomatis akan dibuang. Tindakan membuang model-model tersebut sebenarnya merugikan, sebab model yang diabaikan mungkin telah menangkap properti atau karakteristik data spesifik yang unik. Masalah lain yang kerap muncul pada pemodelan tunggal adalah dilema Bias-Variance Tradeoff, di mana model sangat rentan mengalami kondisi underfitting (terlalu sederhana) atau overfitting (terlalu kompleks dan sensitif terhadap noise).
Untuk mengatasi keterbatasan tersebut, dikembangkanlah konsep Ensemble Learning. Paradigma ini mengusung gagasan bahwa penggabungan beberapa model prediksi individual (weak learners atau base estimators) secara kolektif akan menghasilkan sebuah model agregat yang jauh lebih tangguh, akurat, dan memiliki tingkat kesalahan prediksi yang rendah. Makalah ini disusun untuk membedah secara mendalam konsep dasar Ensemble Learning, dinamika Bias-Variance Tradeoff, teknik mitigasi overfitting, serta metode utama seperti Bagging, Random Forest, dan Boosting sebagaimana dipaparkan pada materi RumahKoding (2020).
2. Keterbatasan Algoritma Tunggal Dalam Pemodelan Prediktif
Pada pendekatan klasifikasi atau regresi konvensional, praktisi sering kali melatih beberapa algoritma sekaligus pada dataset yang sama untuk melihat perbandingan akurasi. Sebagai contoh empiris yang disajikan pada materi pembelajaran RumahKoding, diperlihatkan perbandingan empat algoritma tunggal beserta tingkat akurasinya sebagai berikut:
|
No |
Algoritma Tunggal (Estimator) |
Akurasi Prediksi (%) |
|
1 |
K-Nearest Neighbors (KNN) |
73% |
|
2 |
Decision Tree |
79% |
|
No |
Algoritma Tunggal (Estimator) |
Akurasi Prediksi (%) |
|
3 |
Naive Bayes |
75% |
|
4 |
CART (Classification and Regression Trees) |
77% |
Tabel 1. Perbandingan Performa Algoritma Tunggal
Secara kasat mata, praktisi cenderung langsung memilih Decision Tree karena memiliki tingkat akurasi tertinggi (79%), sementara tiga algoritma lainnya (KNN, Naive Bayes, dan CART) diabaikan begitu saja. Kebiasaan ini memiliki kelemahan mendasar. Setiap algoritma bekerja berdasarkan asumsi matematis dan sudut pandang yang berbeda dalam mempelajari struktur dataset. KNN berfokus pada kedekatan jarak antar data, Naive Bayes mengandalkan probabilitas bersyarat, sedangkan Decision Tree dan CART membuat ruang keputusan berbasis pembagian hirarkis.
Dengan membuang algoritma-algoritma tunggal tersebut, kita sebenarnya kehilangan kesempatan untuk memanfaatkan karakteristik dan properti spesifik yang berhasil ditangkap oleh masing-masing model. Kebijakan ini dinilai tidak efisien karena proses pembangunan dan pelatihan algoritma-algoritma tersebut membutuhkan daya komputasi dan analisis yang signifikan.
3. Konsep Bias-Variance Tradeoff Dan Dinamika Kompleksitas Model
Dalam memodelkan data, tantangan utama yang dihadapi adalah mengelola kompromi antara dua sumber kesalahan (prediction error), yaitu Bias dan Variance. Kompromi ini dikenal sebagai Bias-Variance Tradeoff.
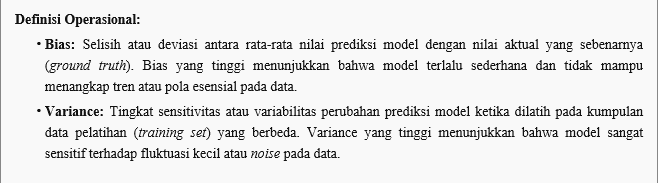
Hubungan antara bias, variance, dan kompleksitas model dapat digambarkan melalui grafik kesalahan prediksi. Seiring meningkatnya kompleksitas model:
• Kesalahan pada data pelatihan (training error) akan terus menurun mendekati nol.
• Kesalahan pada data pengujian (testing error) akan membentuk kurva berbentuk lembah (U-shaped curve). Pada tingkat kompleksitas tertentu, kesalahan pengujian mencapai titik minimum, namun setelah titik tersebut, kesalahan pengujian justru akan melonjak naik kembali akibat fenomena overfitting.
Berdasarkan kombinasi tingkat bias dan variance, terdapat empat kondisi pemodelan:
1. High Bias & High Variance (Kondisi Terburuk): Prediksi model tersebar acak dan jauh dari target acuan. Total kesalahan prediksi sangat tinggi dan model sangat tidak stabil terhadap perubahan data.
2. High Bias & Low Variance (Underfitting): Hasil prediksi terkumpul secara konsisten (homogen) di suatu area, namun lokasinya jauh dari target utama. Hal ini terjadi ketika model terlalu sederhana atau jumlah data pelatihan sangat terbatas, sehingga model hanya mampu memprediksi satu kelas secara dominan.
3. Low Bias & High Variance (Overfitting): Model mampu memprediksi data pelatihan secara sempurna, tetapi prediksinya sangat sensitif dan berfluktuasi tinggi ketika disajikan data baru. Model menghafal noise atau sampel yang tidak valid yang diperoleh dari proses pengumpulan data yang kurang akurat. Algoritma seperti Decision Tree, Support Vector Machine (SVM), dan Neural Networks sangat rentan mengalami kondisi ini jika dilatih terlalu mendalam.
4. Low Bias & Low Variance (Kondisi Ideal): Prediksi model berada secara presisi pada area target dengan tingkat variabilitas yang rendah. Kesalahan prediksi berada pada tingkat paling minimum dan model konsisten terhadap variasi data baru.
4. Strategi Mencapai Kondisi Ideal (Low Bias dan Low Variance)
Untuk meminimalisir kesalahan prediksi dan mengarahkan model menuju kondisi ideal, beberapa langkah terbaik (best practices) yang dapat diterapkan meliputi:
1. Pengumpulan Data yang Andal (Reliable Dataset): Memastikan data diambil melalui metodologi pengukuran dan pencatatan yang valid, terkontrol, dan bebas dari noise ekstrem.
2. Penerapan Cross-Validation (Validasi Silang): Menggunakan teknik seperti K-Fold Cross-Validation untuk membagi data menjadi beberapa subset pelatihan dan pengujian secara bergantian, sehingga memperkecil risiko fenomena overfitting.
3. Eksperimen Parameter & Hyperparameter Tuning: Melakukan pencarian konfigurasi parameter terbaik (misalnya menentukan nilai k optimal pada KNN atau kedalaman maksimum pohon pada Decision Tree) untuk mengontrol kompleksitas model.
4. Pemilihan Metrik Evaluasi yang Tepat: Tidak hanya bergantung pada metrik akurasi standar yang sering kali menyesatkan pada dataset yang tidak seimbang (imbalanced dataset). Evaluasi hendaknya dilengkapi dengan metrik Precision, Recall, F1-Score, dan Area Under ROC Curve (AUC-ROC).
5. Kompetisi dan Kombinasi Algoritma: Membandingkan pelbagai algoritma dan memanfaatkan keunggulan masing-masing melalui strategi ensemble.
5. Konsep Dasar Ensemble Learning
Ensemble Learning adalah metodologi dalam pembelajaran mesin di mana beberapa model individual (sering disebut base models atau weak learners) dilatih untuk menyelesaikan masalah yang sama, kemudian hasil prediksinya digabungkan untuk menghasilkan keputusan akhir yang lebih akurat.
Filosofi utama Ensemble Learning secara analogis mirip dengan proses pengambilan keputusan manusia. Jika seseorang mengambil keputusan penting secara mandiri, keputusan tersebut cenderung berisiko tinggi dan bersifat subjektif karena hanya didasarkan pada satu sudut pandang. Sebaliknya, pengambilan keputusan secara kolektif—melalui musyawarah yang melibatkan banyak individu dengan latar belakang, keahlian, dan pola pikir beragam—akan menghasilkan keputusan yang jauh lebih bijaksana, komprehensif, dan minim kesalahan.
Dalam kerangka kerja Ensemble Learning, seluruh algoritma yang sebelumnya dilatih (misalnya KNN, Decision Tree, Naive Bayes, dan CART) tidak ada yang dibuang. Sampel input yang sama diumpankan ke setiap model individual. Masing-masing model memberikan prediksinya sendiri, dan selanjutnya dilakukan agregasi prediksi melalui:
• Majority Voting / Mode: Digunakan untuk kasus klasifikasi, di mana kelas yang diprediksi oleh mayoritas model dijadikan sebagai output akhir.
• Averaging / Mean: Digunakan untuk kasus regresi, di mana nilai rata-rata dari seluruh prediksi model dijadikan sebagai output akhir.
6. Metode-Metode Utama Ensemble Learning
Secara umum, terdapat tiga kategori utama dalam teknik Ensemble Learning:
1.1 Bagging (Bootstrap Aggregating)
Bagging adalah teknik ensemble yang berfokus pada penguraian nilai variance model. Mekanisme dasarnya adalah membuat beberapa subset data baru dari dataset asli dengan menggunakan teknik resampling with replacement (dikenal sebagai sampel bootstrap). Setiap model individual dilatih secara independen menggunakan subset data yang berbeda tersebut, dan hasil prediksinya diagregasikan pada tahap akhir.
1.2 Random Forest
Random Forest merupakan pengembangan dan penyempurnaan lebih lanjut dari metode Bagging. Pada Bagging standar, pembentukan subset hanya dilakukan melalui acakan baris data (sample bootstrap). Namun pada Random Forest, selain melakukan resampling sampel data, algoritma juga melakukan sampling fitur/atribut secara acak (feature bootstrap). Pembina dasar yang digunakan pada Random Forest secara spesifik adalah Decision Tree. Dengan mengacak baris data dan kombinasi fitur pada setiap pohon, Random Forest membentuk "hutan" pohon keputusan yang sangat beragam dan tahan terhadap overfitting.
1.3 Boosting
Jika Bagging dan Random Forest melatih model-model individual secara independen/paralel, maka Boosting bekerja secara sekuensial (berurutan). Pembentukan model berikutnya sangat dipengaruhi oleh evaluasi kinerja model sebelumnya. Model awal dilatih pada dataset, kemudian sampel data yang salah diprediksi oleh model awal akan diberikan bobot kesalahan (weight error) yang lebih tinggi. Model kedua dilatih dengan fokus memperbaiki kesalahan sampel berbobot tinggi tersebut. Proses ini berulang hingga
membentuk serangkaian model yang saling melengkapi dan secara efektif mampu menurunkan nilai bias dan variance secara simultan.
7. Kesimpulan
Kesimpulan: Pendekatan tradisional yang hanya memilih satu algoritma tunggal terbaik dan mengabaikan algoritma lainnya kurang efisien karena membuang informasi dan sudut pandang spesifik yang telah dipelajari oleh masing-masing model. Pengelolaan Bias-Variance Tradeoff merupakan kunci utama dalam membangun model machine learning. Kondisi ideal low bias dan low variance dapat dicapai melalui jaminan kualitas dataset, validasi silang (cross-validation), optimasi hyperparameter, serta pemilihan metrik evaluasi yang tepat. Ensemble Learning menghadirkan solusi unggul dengan memanfaatkan prediksi kolektif dari berbagai model individual melalui metode Bagging, Random Forest, maupun Boosting.
DAFTAR PUSTAKA
Breiman, L. (1996). Bagging predictors. Machine Learning, 24(2), 123-140.
Breiman, L. (2001). Random forests. Machine Learning, 45(1), 5-32.
Hastie, T., Tibshirani, R., & Friedman, J. (2009). The Elements of Statistical Learning: Data Mining, Inference, and Prediction (2nd ed.). Springer.
RumahKoding. (2020, 16 November). Machine Learning: Konsep Dasar Ensemble Learning [Video].
YouTube. http://www.youtube.com/watch?v=CECrmwyrrZY
Zhou, Z. H. (2012). Ensemble Methods: Foundations and Algorithms. CRC Press.